Herkes İçin Yazılım
Konu 2
Bilgisayar sesi nasıl duyar?
7’den 70’e herkes için. Önceden hiçbir şey bilmen gerekmiyor.
Merhaba, ben Müzisyen Oğuz. Bir tel çekeceğim, kulak ver.
Duyuyor musun?
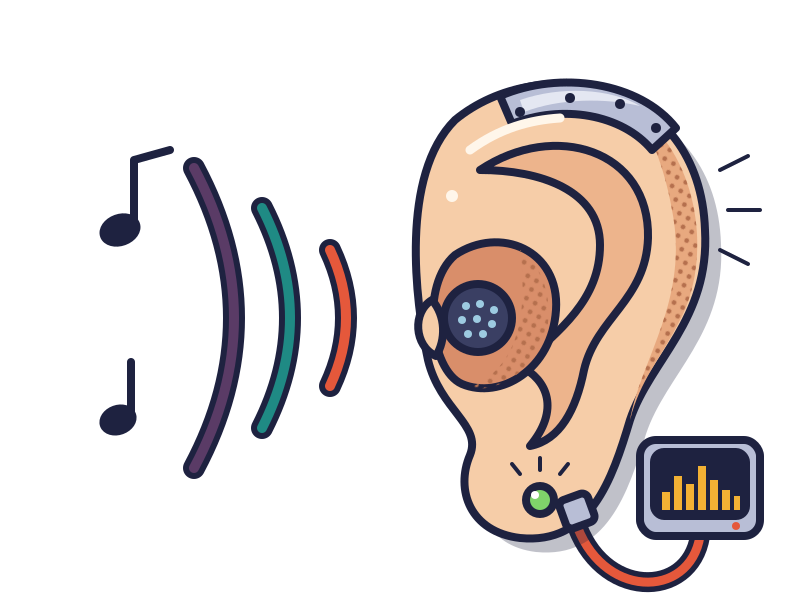
Tel titriyor, hava titriyor.
Gitarın telini çektim. Bak, tel ileri geri gidip geliyor. Gidince havayı itiyor, dönünce geri çekiyor. Hava bir sıkışıyor, bir gevşiyor. Bu dalga odada yayılıp kulağına geliyor.
Peki bilgisayar bu dalgayı nasıl tutar?
Kalın tel yavaş, ince tel hızlı.
Gitarın en kalın teli Mi, saniyede yaklaşık 82 kez titrer. Saymaya yetişemezsin. Bu hızın adı 82 hertz, kısaca 82 Hz.
Basın en kalın teli genelde bir oktav aşağıya akort edilir: 41 Hz, tam yarısı. Akortta kullanılan La notası ise 440 Hz.
İnsan kulağı kabaca 20 Hz ile 20.000 Hz arasını duyar.
Mikrofon duymaz, ölçer.
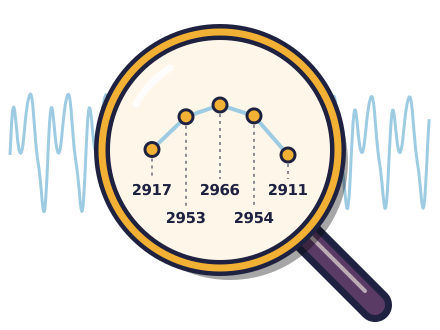
Mikrofon havanın ne kadar sıkıştığını ölçüp bir sayıya çevirir. Bunu saniyede 44.100 kez yapar.
Neden bu kadar? Dalgayı kaçırmamak için her titreşimde en az iki kez ölçmen gerekir. Kulağın duyduğu en tiz ses 20.000 Hz. Demek ki saniyede 40.000’den fazla ölçüm lazım.
Tek kanalda bir saniyelik şarkı 44.100 sayı eder.
Bu sayıların hiçbirinde “akordeon” yazmaz.
Aynı nota, üç ayrı ses.
Gitardan bir La çaldım, akordeondan bir La, sonra La’yı ben söyledim. Üçü de 440 Hz ama birbirine hiç benzemiyor.
Çünkü bu üç sesin hiçbiri tek bir hızda titremiyor. 440’ın yanında 880, 1320 ve daha yukarıdaki katlar da çalıyor. Bu katların adı harmonik. Her enstrüman onları kendi oranında karıştırır. Sesin rengi büyük ölçüde buradan gelir.
Akordeonda titreşen şey tel değil: körükten gelen hava, ince metal bir dilin üstünden geçerken onu titretir.
gitar
akordeon
ses
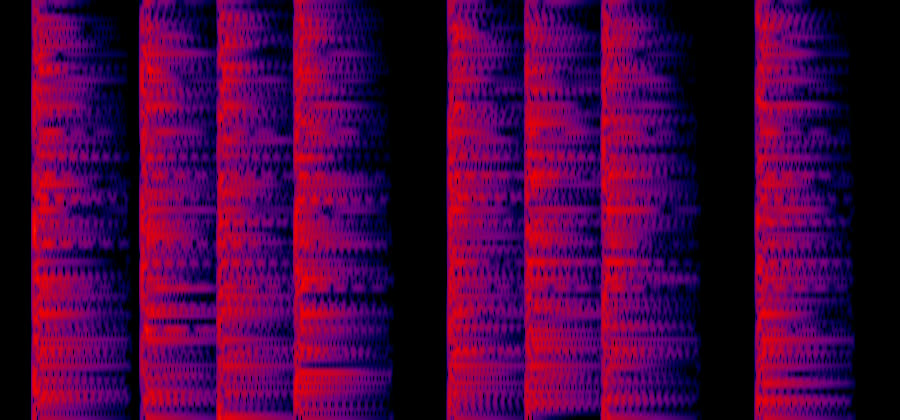 zaman →
titreşim hızı ↑
Sesin resmini çizelim.
Bilgisayar sesi çoğu zaman önce resme çevirir, sonra ona bakar. Soldan sağa zaman akar, aşağıdan yukarı titreşim hızı artar. Nokta ne kadar parlaksa, o anda o hızda o kadar çok ses var. Bu resmin adı spektrogram.
Flamenkoda tellere tırnakla hızlı hızlı vurunca resimde dikey şeritler çıkar. Her vuruş bir anda bütün hızlara dokunur.
Videomdaki vızıltı.
Haftalık videomu çekerken arkada bir vızıltı vardı. Resme çevirince hemen göründü: 50 Hz’te dümdüz bir çizgi, sonra 100’de, 150’de, üst üste.
Türkiye’de prizdeki elektrik saniyede 50 kez yön değiştirir. Kablolar bu titreşimi mikrofona sızdırınca uğultu olur.
Şarkım resimde kıvrılıyor, uğultu hiç kıpırdamıyor. İkisini ayırmanın ipucu bu.
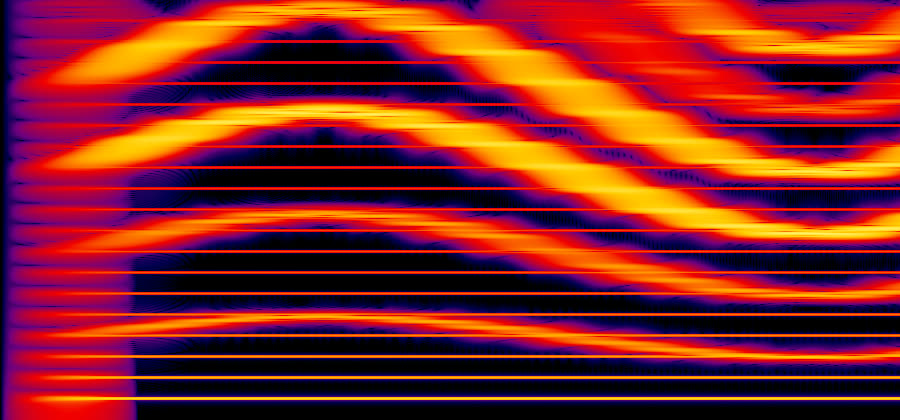 zaman →
titreşim hızı ↑
uğultu: 50 · 100 · 150 Hz
şarkı
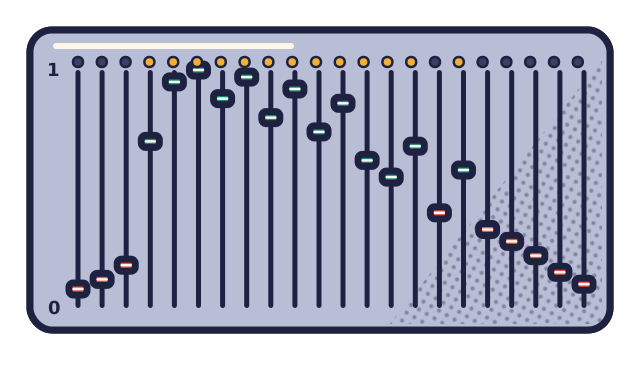
22 sürgülü bir mikser.
Birinci sayıda gördük: model, içindeki ayarlanabilir sayıları azar azar düzelterek öğrenir. Peki gürültü temizleyen bir model neyi ayarlıyor?
RNNoise adlı küçük bir modele bakalım. Sesi kalından inceye 22 banda bölüyor. Sonra her an, her bant için 0 ile 1 arasında bir sayı söylüyor. 1 “bırak” demek, 0 “kıs” demek. Yani model 22 sürgülü bir mikser gibi. Sürgüleri kendisi itiyor.
Bunu nasıl öğrenmiş? Yazarları temiz konuşma kayıtlarına gürültü kayıtları karıştırıp modele göstermiş. Karışımı kendileri yaptıkları için doğru cevabı biliyorlar.
Modelin tamamı 85 kilobayt. Telefonla çektiğin tek bir fotoğraftan küçük.
Ben ne denedim?
Önce elle denedim. Uğultu 50 Hz’te ve katlarındaydı. Onları tek tek kestim. Uğultu azaldı. Ama konuşmanın altındaki hışırtı yerinde kaldı.
Sonra RNNoise’u ekledim. Daha iyi oldu. En temiz sonucu ise para verdiğim kurgu programının yapay zekâlı gürültü azaltması verdi.
Dürüst not: Elle yaptığın iş sana öğretir, çünkü ne yaptığını tam bilirsin. Öğrenmiş model ise kuralını yazamadığın şeyi de yakalar.
Makas: elle kestim
Küçük mikser: RNNoise
Büyük mikser: yapay zekâ
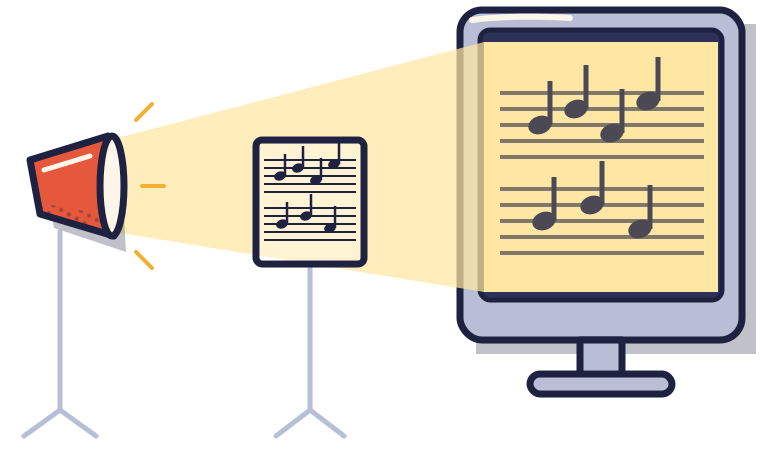
Model dinlemiyor, resme bakıyor.
Videoma altyazı çıkarmak için Whisper adlı bir model kullandım. 680.000 saatlik sesle eğitilmiş. Hiç durmadan dinlesen bir insan ömrü kadar sürer.
Peki Whisper sesi nasıl okuyor? Önce sesi saniyede 16.000 ölçüme indiriyor. Sonra 80 banttan oluşan bir spektrograma çeviriyor. O resmi de 30 saniyelik parçalar hâlinde okuyor.
Yani model sesi dinlemiyor. Sesin resmine bakıyor.
Burada benzetme kırılıyor: ekrandaki resim bir gölge değil. Bilgisayar onu sayılardan hesaplıyor.
Sıradaki parça ne?
Müzik üreten modeller sesi küçük parçalara böler, tıpkı cümleyi kelimelere böler gibi. MusicGen adlı model her saniyeyi 50 ana ayırıyor. Her an için 4 sayı yazıyor.
Telefon klavyen sıradaki kelimeyi tahmin eder ya. Bu model de sıradaki parçayı tahmin ediyor. Parçalar art arda dizilince müzik çıkıyor. Model 20.000 saatlik lisanslı müzikle eğitilmiş.
Bir gün kendi müziğimi böyle üretmek istiyorum. Ama önce gitarımı bırakmayacağım.
Nota yerine sayı!
Model nerede yanılıyor?
Model yalnızca duyduğu örneklerden öğrenir. Duyduğu da her zaman doğru değil.
Tanıdığı kelimeye benzetir
Videomdaki otomatik altyazı bir semt adını kaba bir söze çevirdi. Whisper da aynı yanlışı yaptı. İki model aynı hatayı yapınca birbirini düzeltemedi. Sonunda bir insan bakıp yakaladı.
Altyazı var, ses yok
Arkadaşlarımın konuştuğu yerlerde ses kısık kalmıştı. Model sözleri yazmıştı ama izleyen duyamıyordu. Bunu da ölçerek bulduk.
Bantlar kaba
RNNoise her bant için tek bir sayı söylüyor. Aynı bantta hem konuşma hem gürültü varsa ikisini birlikte kısar ya da birlikte bırakır. Yazarı da bunu söylüyor: bantlar, notanın katları arasındaki gürültüyü ayıklayacak kadar ince değil. O kısmı ayrı bir filtreyle temizliyorlar.
Sıra sende
Sessiz bir odada telefonunla 10 saniye kayıt al, sonra dinle.
Buzdolabının, lambanın ya da bilgisayarın uğultusunu duyuyor musun? Bir model hangisini “gürültü” sayardı, sen hangisini “müzik” sayardın?
Uğultu ve altyazı örnekleri, Oğuz’un haftalık videosunun kurgu notlarından. Bu sayıdaki sesler kayıt değil, bilgisayarla üretildi. Model sayıları, modelleri yazanların kendi yayınlarından: RNNoise (Jean-Marc Valin), Whisper (Radford ve arkadaşları, 2022), MusicGen (Copet ve arkadaşları, 2023).
Başa dön